技术与模型
自研教育垂直大模型
课堂文本大模型 + 多模态大模型,专为课堂场景训练。
全系自研的双模型底座
麦盟依托全系自研的 「课堂文本大模型 + 多模态大模型」 技术底座,以「VibeEDU」智能引擎为核心,能力覆盖「课堂分析」与「教师能力画像」两大场景,实现「一课一评价、一师一画像」。平台沉淀上千万小时课堂数据,受益学生超 6000 万人。
关键技术指标
课堂场景里,通用模型最容易出错的是专业表达:数学公式、古文断句、师生角色区分。以下是麦盟模型与通用模型的对比:
| 指标 | 麦盟 | 通用模型 |
|---|---|---|
| 语音转文字错误率(CER) | 低至 3.2% | 5%~8% |
| 角色分离准确率 | 95% | — |
| 数学表达式准确率 | 99.5% | 82% |
| 古文课堂断句准确率 | 98% | 70% |
| 算法识别准确率 | 98% 以上 | — |
为什么需要教育垂直模型
课堂语音不是普通对话
一节课里有教师讲授、学生回答、齐读、讨论,还有板书公式和古文朗读。识别错一个公式、断错一句古文,后面的提问分析和目标达成判断都会跟着偏。角色分离准确率决定了系统能不能分清「谁在说话」,这是分析师生互动结构的前提。
评价框架来自教研实践
评价体系源于中国教育科学研究院课题、各学科最新新课标与国内外经典课堂观察理论,融合 LICC 范式、CFS 量规及布鲁姆、弗兰德斯、DOK 等模型,并联合北师大、首师大专家共建。
麦盟艺行的评价体系,融合了经典教育评价理论,并在与中国教科院、北师大、首师大等专业机构的项目合作中不断打磨。
产学研合作
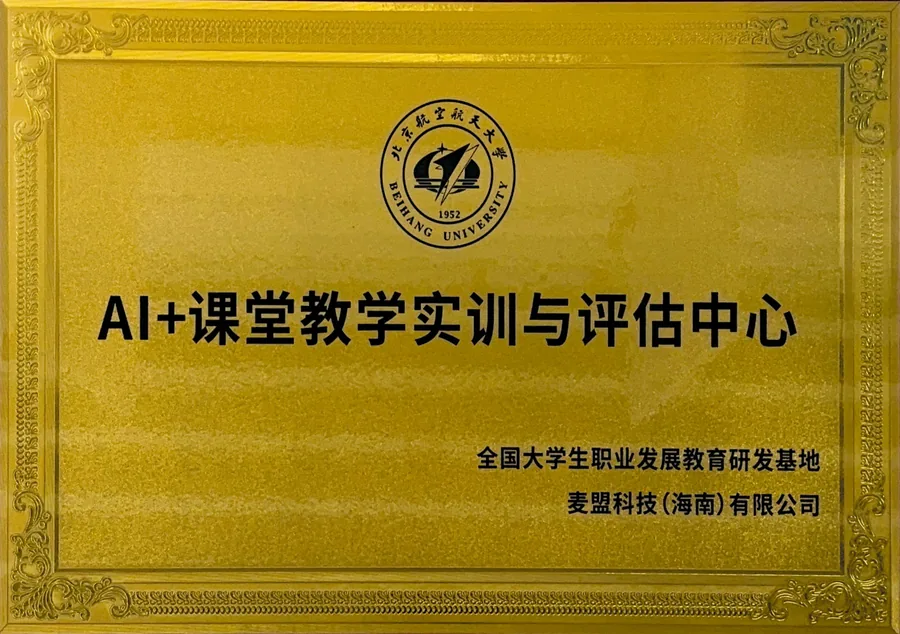
公司与北京航空航天大学共建「AI + 课堂教学实训与评估中心」(全国大学生职业发展教育研发基地)。
麦盟艺行电话:17758038279邮箱:maimengyixing@163.com地址:浙江省杭州市西湖区莲池南路 66 号 A 幢 0305 室